2026/10/08|同一天兩次水聲進食:早餐吃完,晚餐最後退出
2026/10/08|同一天兩次水聲進食:早餐吃完,晚餐最後退出
Section titled “2026/10/08|同一天兩次水聲進食:早餐吃完,晚餐最後退出”07:20|有客人的早上,濕區水聲早餐 90 g 吃完
Section titled “07:20|有客人的早上,濕區水聲早餐 90 g 吃完”今天家裡有朋友,稍後我們要外出,所以我把早餐提前到 07:20。志強仍在廁所濕區、配著流水聲吃狗糧;這餐是 90 g,最後全部吃完。
進食過程中,我記到牠全身抖動 3 次、回頭看我 1 次。牠沒有完整退出;吃完後留在原處,等我清理完畢,再聽到我的釋放詞才離開。這個流程顯示牠今天能在水聲條件下完成早餐,也能跟著既有的餐後順序走,釋放詞與熟悉流程各有多少作用,接著比較;牠也可能只是熟悉流程,或仍在謹慎等待。
若與前幾次對照:10/4 是 60 g,碰到碗後多次退避又返回;10/5 是 90 g,約抖動 6~7 次但沒有完整退出;今天同為 90 g,抖動 3 次、回頭 1 次。這些紀錄可以用來看恢復能力,比較時也記每天的作息、聲音、前置活動與環境,讓恢復變化有更完整的依據。
早餐時|中島附近自主坐下,卻拒吃一顆狗糧
Section titled “早餐時|中島附近自主坐下,卻拒吃一顆狗糧”家人吃早餐時,志強看到我在中島附近準備東西,又自己坐下等待。過去這個情境常會換到一顆狗糧,但這次我把狗糧給牠看,牠沒有吃。牠先拒吃這顆狗糧,之後才喝牛奶。
我因此問 ChatGPT:牠是不是已經學到「人在中島準備東西,可能會有更好吃的」?ChatGPT 認為可以同時保留三個非排他的可能性:
- 中島、我的動作與坐下等待已形成環境線索和操作制約。
- 過去的牛奶、優格或其他高價值食物,可能提高牠對後續獎勵的相對期待。
- 牠才剛吃完 90 g 早餐,單純飽足也可能讓一顆狗糧失去吸引力。
這次先按拒吃在前、牛奶在後的順序理解,再從後續相近情境比較原因。ChatGPT 建議我不要在拒絕狗糧後每次立刻固定升級食物,也不必強迫牠吃;若要保留在中島等待的行為,可以安排回位、等待或其他不一定靠食物兌現的練習。這些是討論中的建議,我還沒有承諾作為固定規則。
早餐後|少量牛奶、紅肉火龍果與優格
Section titled “早餐後|少量牛奶、紅肉火龍果與優格”之後我給志強一般牛奶,目測少於、至多約 15 cc,沒有秤重;接著還有紅肉火龍果加優格,兩者都沒有量化。當天的照片與影片所記錄的事件,是志強在粉色狗碗內持續舔食火龍果與優格混合物,最後接近舔乾淨。這能支持當下願意吃、適口性高,各成分的偏好與腸胃耐受,另外逐項觀察。
ChatGPT 提醒我:一般牛奶含乳糖,部分狗可能出現軟便;紅肉火龍果宜只給少量果肉,之後糞便可能染色,但若真的看到疑似血便,不能只用食物顏色帶過;優格則要確認沒有添加糖與木糖醇。10/7 晚上志強已吃過優格與少量鮮羊乳,今天又有牛奶、火龍果和優格,若後續 12~24 小時出現軟便、腹脹、排氣或嘔吐,也會因變因太多而較難歸因。
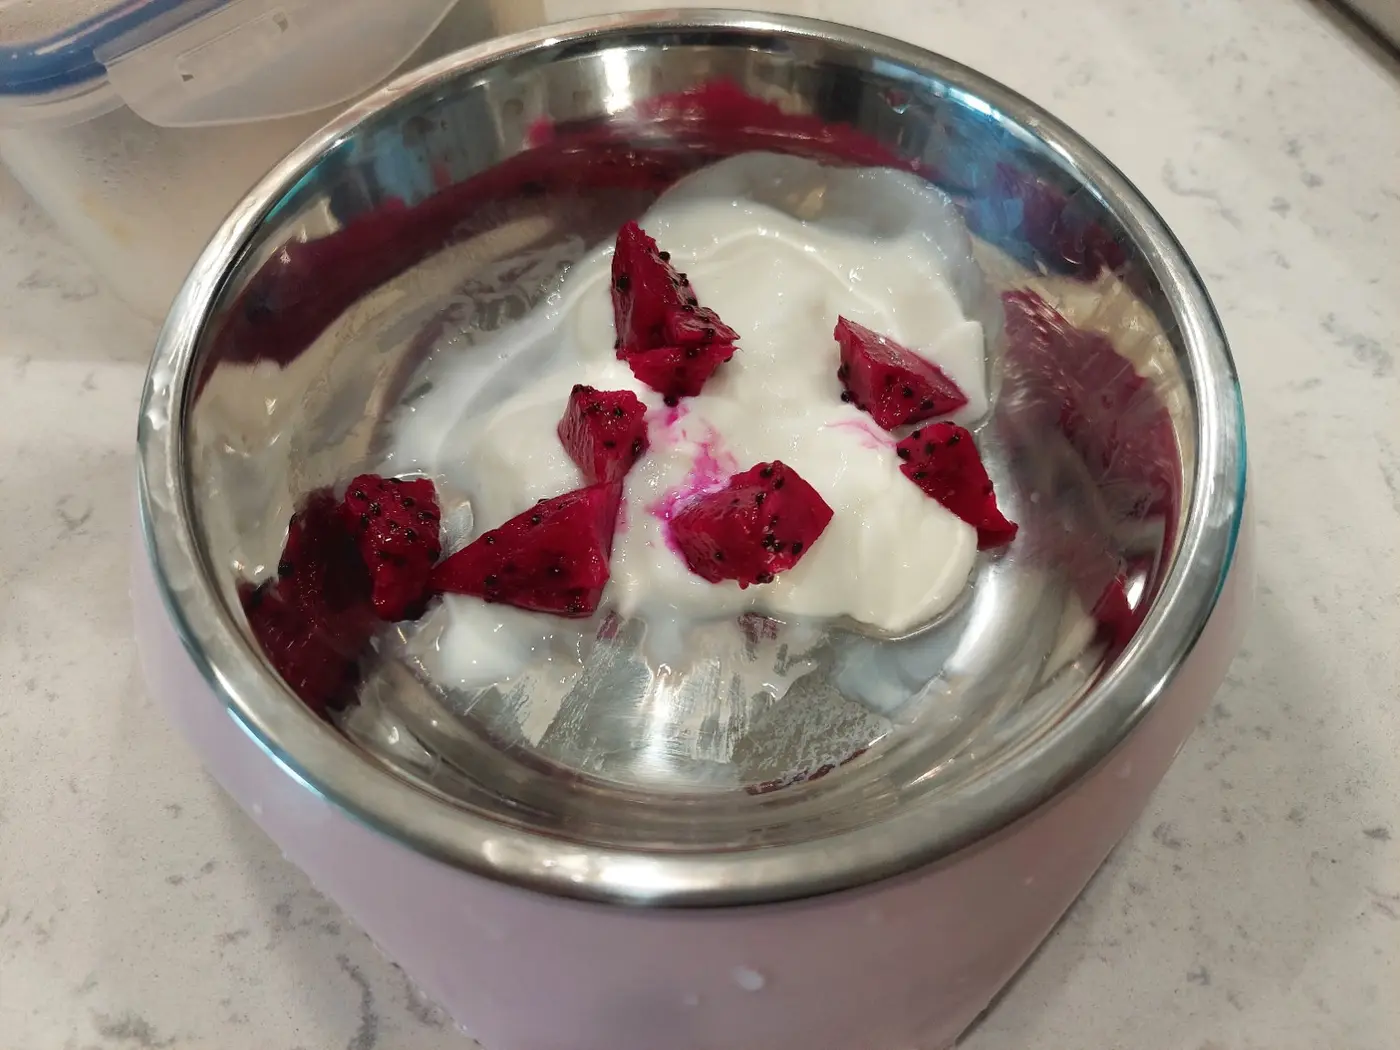
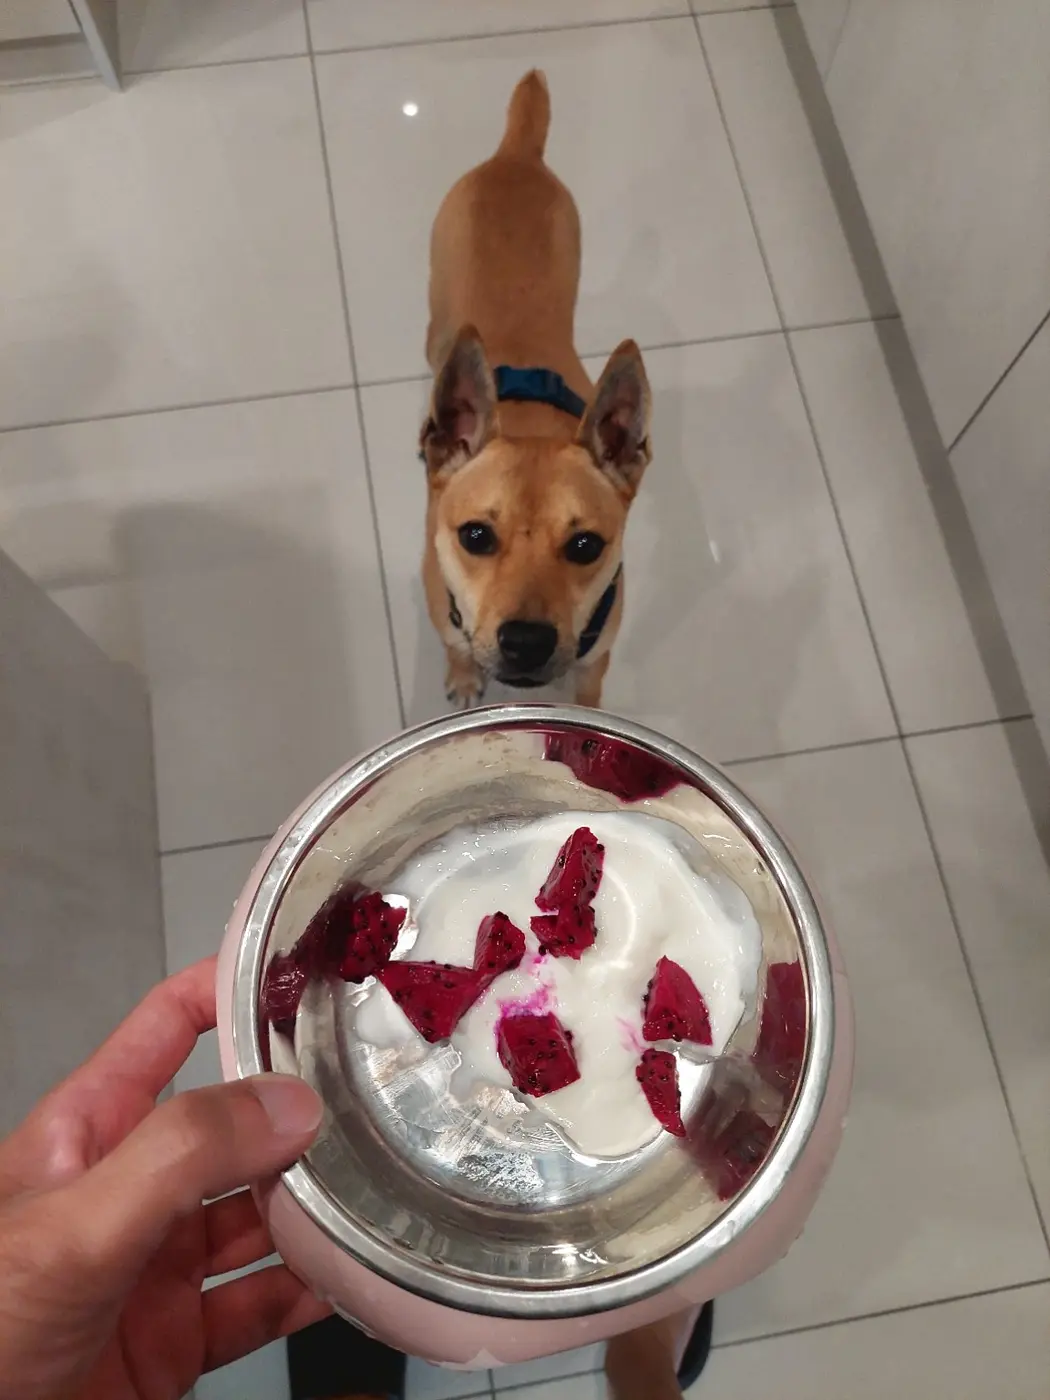
影片中,志強先看著我手上的碗,碗放低後靠近並持續舔食,後段仍沿著碗底舔食。這段記錄的是早餐後的火龍果優格,不是濕區水聲正餐。
19:30–20:00|延後散步,晚餐出現兩階段退出
Section titled “19:30–20:00|延後散步,晚餐出現兩階段退出”今天中下午到傍晚,我們多數時間在外面;白天曾到社區 KTV,但沒有足夠觀察可以把特定反應歸因於那段活動。晚間散步延到約 19:30 才開始,約 20:00 回家後放飯。今天沒有安排其他正式訓練,當天的生活刺激仍包括:朋友在家、家人外出、散步時段延後,以及散步回來後不久吃飯,都只能先列為可能變因。
晚餐仍安排在廁所濕區並開流水聲。志強進食期間全身抖動共 4 次。前兩次抖動後,牠先退到乾區或門口附近,之後又自己回到濕區繼續吃;後來牠再度退出,這一次直接離開廁所,沒有再主動回去。這裡要把「曾自行返回」和「最後不再返回」分開看:前段仍有接近—迴避後的恢復,後段則顯示當下已不再選擇繼續。
晚餐最後約剩 40 g;起始供糧量待確認,這餐先記實秤剩40g。我出去看時,志強望著我一陣子後低下頭;我當時覺得牠像是「故意低頭」,ChatGPT則建議把語氣、目光和後續動作一起看,了解當下的反應。
同一天早上牠在相同大方向的濕區水聲條件下吃完 90 g,晚上卻中途離開。這表示結果受到時段與前置條件影響,但上午、晚間的活動、休息、點心和聲音狀態並不相同,前後條件與身體反應一起列入比較。全身抖動也是需要結合退出、返回、首口延遲和完成度解讀的訊號,再看整段進食與恢復情形。
晚餐後|收起約 40 g,並修正「退出後續餐」的建議
Section titled “晚餐後|收起約 40 g,並修正「退出後續餐」的建議”我當面把剩餘狗糧取出並收起來,志強看見狗糧時有輕微跳躍。當晚後續沒有再給任何食物,包括原本可能提供的火龍果優格;我們也沒有太多互動。這是我實際採取的處理。ChatGPT 另外提醒,不應把減少互動當成對志強的懲罰。
我原先懷疑:是不是志強已經預期晚間還有優格等更好吃的,所以狗糧才吃得隨便。ChatGPT 認為,從四次抖動、退出、返回再退出的行為序列看,水聲與濕區造成的接近—迴避衝突有較直接的線索;但點心期待仍是待驗假說,現有資料不足以排除,也不足以定論。
討論中,ChatGPT 一開始曾建議晚餐先降難度並暫停點心。我質疑,不該因單次異常就立刻降難度;我提出下一次先恢復正常作息,散步回來休息後,再用原條件比較。ChatGPT 後來改為有條件支持這個對照方式,同時保留安全界線:如果反覆出現明顯退出或恐懼,就停止當次練習並重新評估。當時先採比較正常作息下原條件的方向,降難度與停優格5~7天仍是曾提出的選項。
更重要的是,ChatGPT 曾提議志強退出後,把剩餘狗糧搬到外面繼續餵,並誤稱這不會獎勵退出。我立刻指出:若形成固定序列,志強可能學到「退出就能在外面繼續吃」。ChatGPT 隨後明確認錯並修正:退出本身可能因離開不舒服的水聲而受到負增強;若每次退出後又在安全處續餐,也可能正增強退出。這次的修正重點,是後續避免固定形成退出後在外續餐的獎勵鏈,並繼續觀察。
修正後,ChatGPT 的管理建議是:短暫退出後若自行返回,保持中性、不強逼;完全離開且不返回,就平靜結束當次水聲進食,不固定當場搬到外面續餐。若多次顯示難度過高,應在下一餐開始前就決定安全的正餐地點,並把低強度水聲練習另外拆開,而不是用挨餓、強留廁所或冷處理來懲罰。這仍是 ChatGPT 的建議,不是我已承諾採用的長期規則。
今天的整體判斷與下一次記錄
Section titled “今天的整體判斷與下一次記錄”今天最重要的不是把早上判成「成功」、晚上判成「退步」,而是同一隻狗在不同前置條件下,對相似場景做出不同選擇。早上能吃完、抖動後持續進食;晚上前段也曾退出後自行返回,最後才完全離開。這條時間線比單看清盤或剩食更能幫助我調整難度。
下一次若要比較,我會優先把資料記完整:起始克數與剩餘量、散步回家到放飯的休息間隔、流水聲強度、第一口延遲、抖動性質與次數、退出位置與次數、是否主動返回、最後是否吃完,以及當天的腸胃或其他健康異常。若正常作息下仍重複同型退出,就把相同作息下的重現情況與今天並列比較,逐步釐清各個條件的作用。