80 g 濕區早餐、機車預期逃避與約 60 g 晚餐
2026/10/02|80 g 濕區早餐、機車預期逃避與約 60 g 晚餐
Section titled “2026/10/02|80 g 濕區早餐、機車預期逃避與約 60 g 晚餐”到家第 77 天,星期五。
早餐:自己回到無水聲濕區,80 g 吃完
Section titled “早餐:自己回到無水聲濕區,80 g 吃完”早上我把 80 g 狗糧放在淋浴間濕區,沒有開水。志強起初跟著我往外走;我沒有堵住牠,也沒有把牠推回去,只在通道上讓出空間。牠之後自己轉回濕區開始吃,最後全部吃完。
今天最值得記錄的不是單純「有吃完」,而是牠在已經跟著人離開之後,仍能自己重新選擇回到食物所在的位置。這比只有在我指向濕區後才進入,多了一層對「濕區裡有早餐」的情境連結;這次先記無水聲條件下的完成,水聲版本另外比較。
下午 30 g 配額:嘴套、準備、坐下與趴下
Section titled “下午 30 g 配額:嘴套、準備、坐下與趴下”下午我先分出 30 g 狗糧作為整段訓練配額。嘴套做約五、六回合,志強可以把鼻口伸進去並維持短暫參與,這一段相對穩定;今天仍是短回合,不把它寫成已能長時間配戴。
「準備」一開始仍用三顆狗糧串起位置與轉向;累積約三十次後,我把其中一個位置的獎勵減掉,改成兩顆。志強從我身後繞過,再轉約 180 度回到正面,減少一個獎勵點後仍能繼續參與。這表示今天可以開始把連續誘導拆小,但還不是完全拿掉提示。
坐下時,我讓牠看著手中食物約六秒;其中一次牠較早把頭轉開,我便降低等待難度,而不是硬把秒數撐滿。趴下則讓食物在約二、三秒後就能真正舔到,保留一點等待,同時維持「最後拿得到」的可預測性。今天確認的是牠在小挑戰下仍願意留在回合裡,不把這些回合改寫成完整口令已定型。
第一次居家敏捷遊戲:兩張椅子形成可走的路線
Section titled “第一次居家敏捷遊戲:兩張椅子形成可走的路線”今天第一次在家安排簡化的敏捷遊戲。我用兩張餐椅形成路線,讓志強穿過椅子間的空隙、繞過椅子,從客廳移動到餐廳,也從桌下通過,約做四、五輪。
整段主要靠手勢與食物引導,重點是讓牠在安全、低高度的環境中改變方向、理解路徑並跟著人移動。這不是正式競賽敏捷,也沒有跳躍或追求速度;今天只記錄成第一次居家可控路線遊戲。牠願意走完整個路徑,代表這種空間遊戲目前可以作為低壓力的變化,但仍要避免一次加入太多障礙或把路線做得太窄。
運輸箱:25 分鐘、每兩分鐘一顆
Section titled “運輸箱:25 分鐘、每兩分鐘一顆”運輸箱今天拉長到 25 分鐘,約每兩分鐘給一顆狗糧,全程順利完成。和前幾天二十分鐘、較短給食間隔相比,今天同時延長總時間並拉長獎勵間隔;雖然完成了,下一次較適合先鞏固,而不是再同時增加兩個變項。
這次的意義是志強能在較長等待中維持,而不是「已經可以無限延長」。後續仍要看牠進箱是否主動、身體能否真正休息,以及離箱前是否因預期下一顆而持續高張。
訓練後少量無糖豆漿:舔完,但份量未量
Section titled “訓練後少量無糖豆漿:舔完,但份量未量”所有下午訓練結束後,我在碗底倒了很薄一層義美古早傳統無加糖豆奶,志強全部舔完。這次沒有量出精確毫升數,所以只記「薄薄一層」,不補推份量。
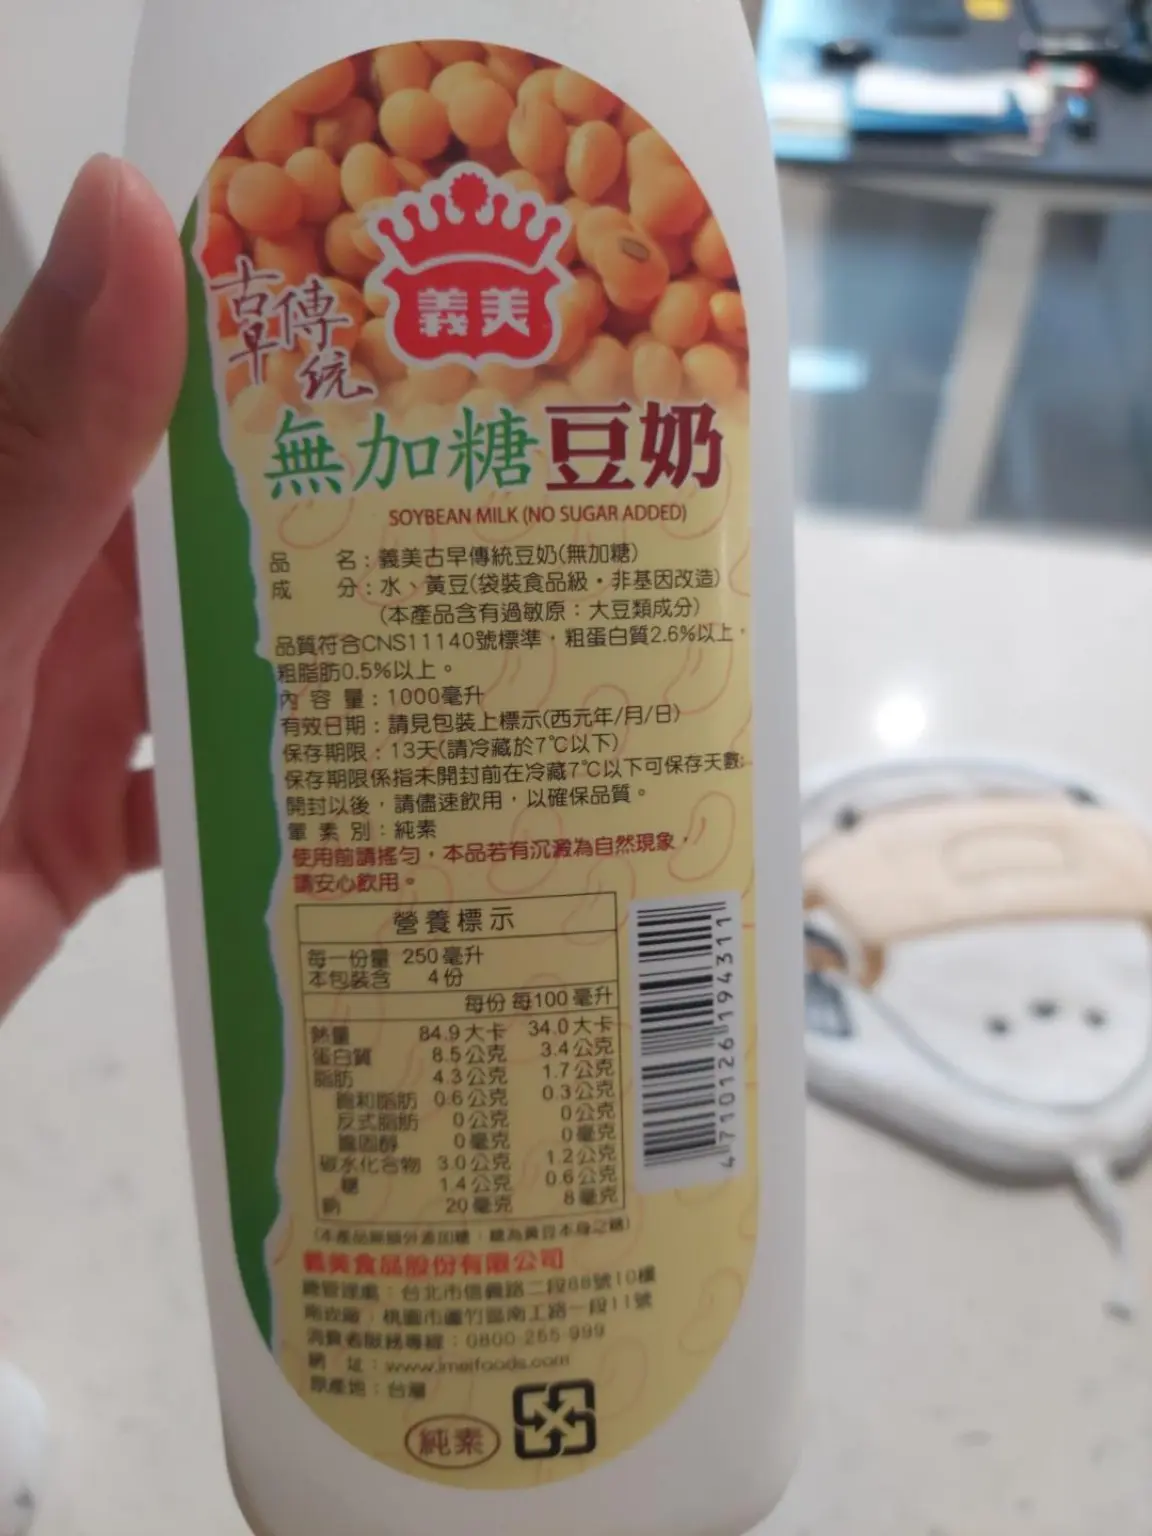
這是少量試吃,不把一次舔完解讀成長期耐受。豆漿即使無加糖,也不是主食;後續十二至二十四小時留意軟便、腹瀉、嘔吐、放屁明顯增加、抓癢或精神食慾改變。今天沒有記錄上述異常。
晚間生活照:「不要拍不要拍」的遮臉瞬間
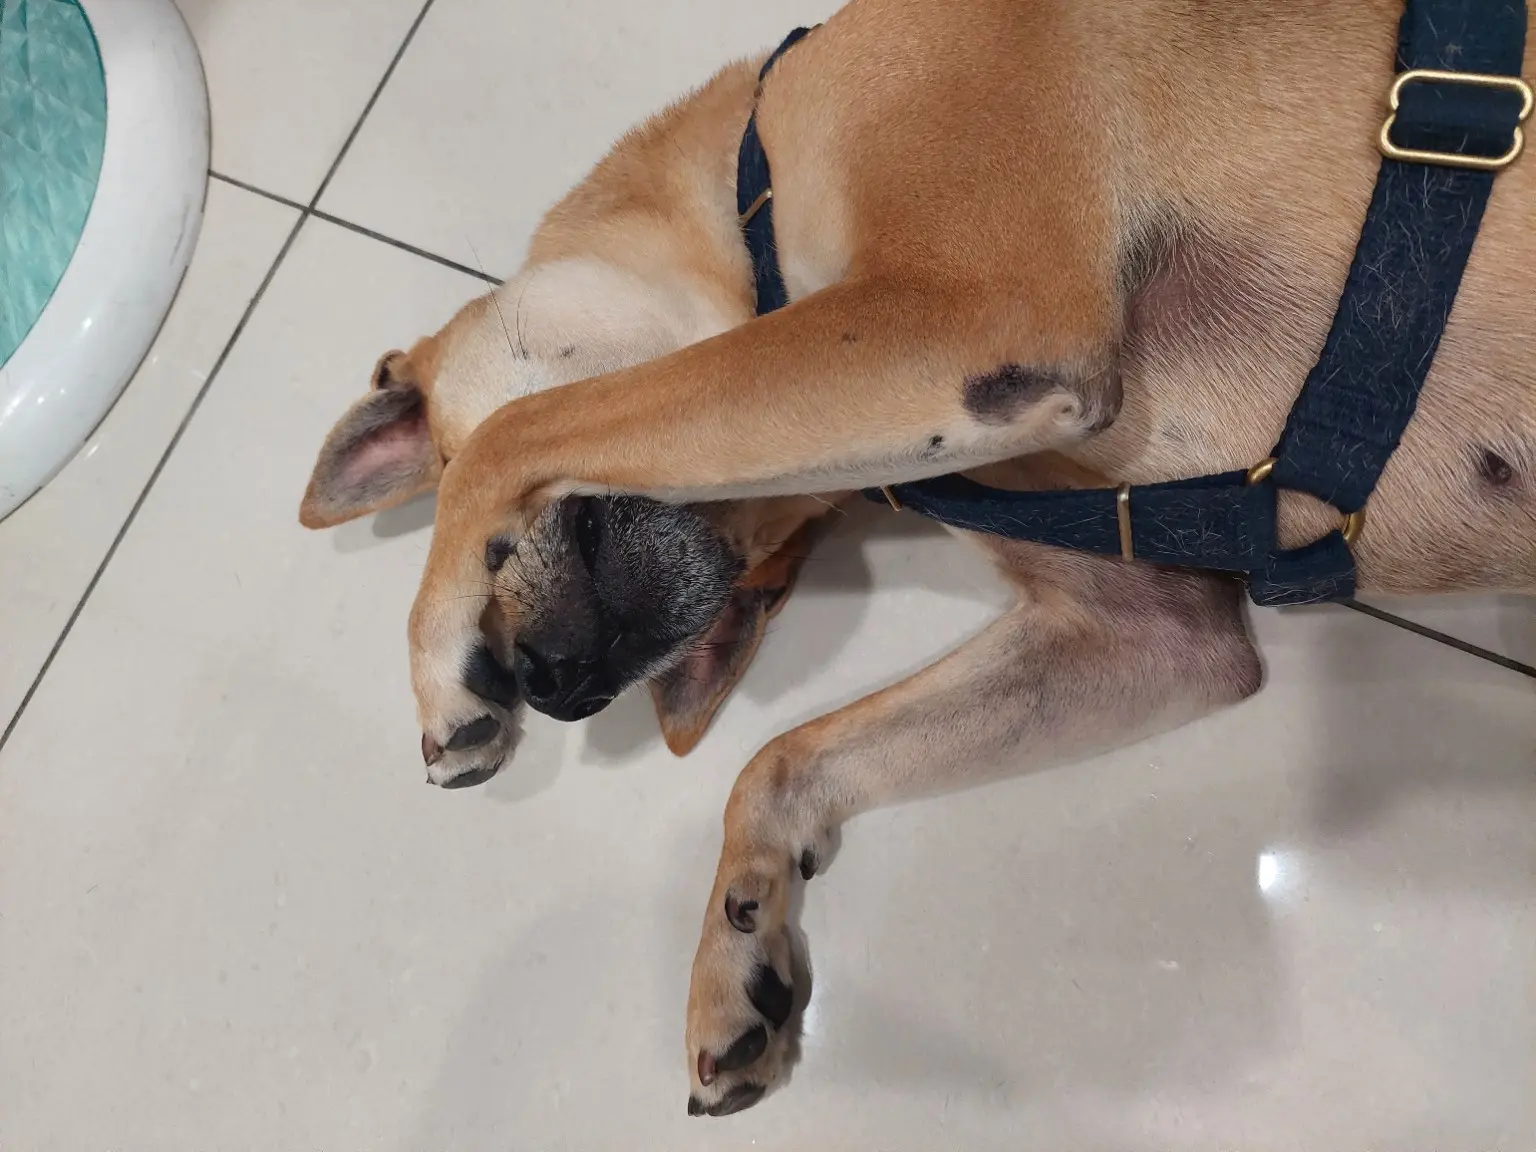
Section titled “晚間生活照:「不要拍不要拍」的遮臉瞬間”傍晚我拍到志強把前腳抬到臉前的瞬間,後來也做成「不要拍、不要拍」的梗圖。原照與梗圖都保留下來;這是一個有趣的單幀畫面,我用「不要拍」替當下的遮臉姿勢配上玩笑。
B1:刻意慢走後腳抖、完成後重喘
Section titled “B1:刻意慢走後腳抖、完成後重喘”晚間下樓後,我照原本安排走 B1 樓梯。志強在停車場情境裡仍一直想離開,我用牽繩把牠帶進樓梯。這次我刻意控制速度,讓牠大致和我一樣慢;行走時我看見牠出力到腳會發抖,走完後也非常喘。我在出口附近等約十五至二十秒,才讓牠離開。
這段腳抖及重喘由我現場描述,幅度、牽繩張力與恢復時間可在後續補記。ChatGPT 的分析是,這裡可能同時有停車場壓力、拉扯、上樓的心肺負荷,以及刻意慢速使每一步支撐時間變長的肌肉負荷;腳抖要連同站姿、活動與環境刺激一起理解。
老師回覆這類 B1 練習沒有問題、可以繼續。我把老師的方向與 ChatGPT 的負荷提醒分開保留:可以繼續練,但目標較適合是「不要暴衝、速度可控制」,不必要求慢到和人完全同速。十五至二十秒也不是固定完成門檻;比秒數更重要的是呼吸是否開始下降、身體是否變鬆、能否重新嗅聞或注意環境。
機車:靠近前已想離開,上車後由站立被協助坐下
Section titled “機車:靠近前已想離開,上車後由站立被協助坐下”B1 之後先去騎腳踏車散步,再進行機車訓練。這次還在靠近機車時,志強就出現想離開的反應;我認為牠可能已預測接下來會被帶上車。我仍從胸背附近協助把牠抱上去。牠剛上車時四腳站立,我壓了一下屁股後牠才坐下;坐著時又慢慢往外緣移,我需要把牠的身體再往內調整。
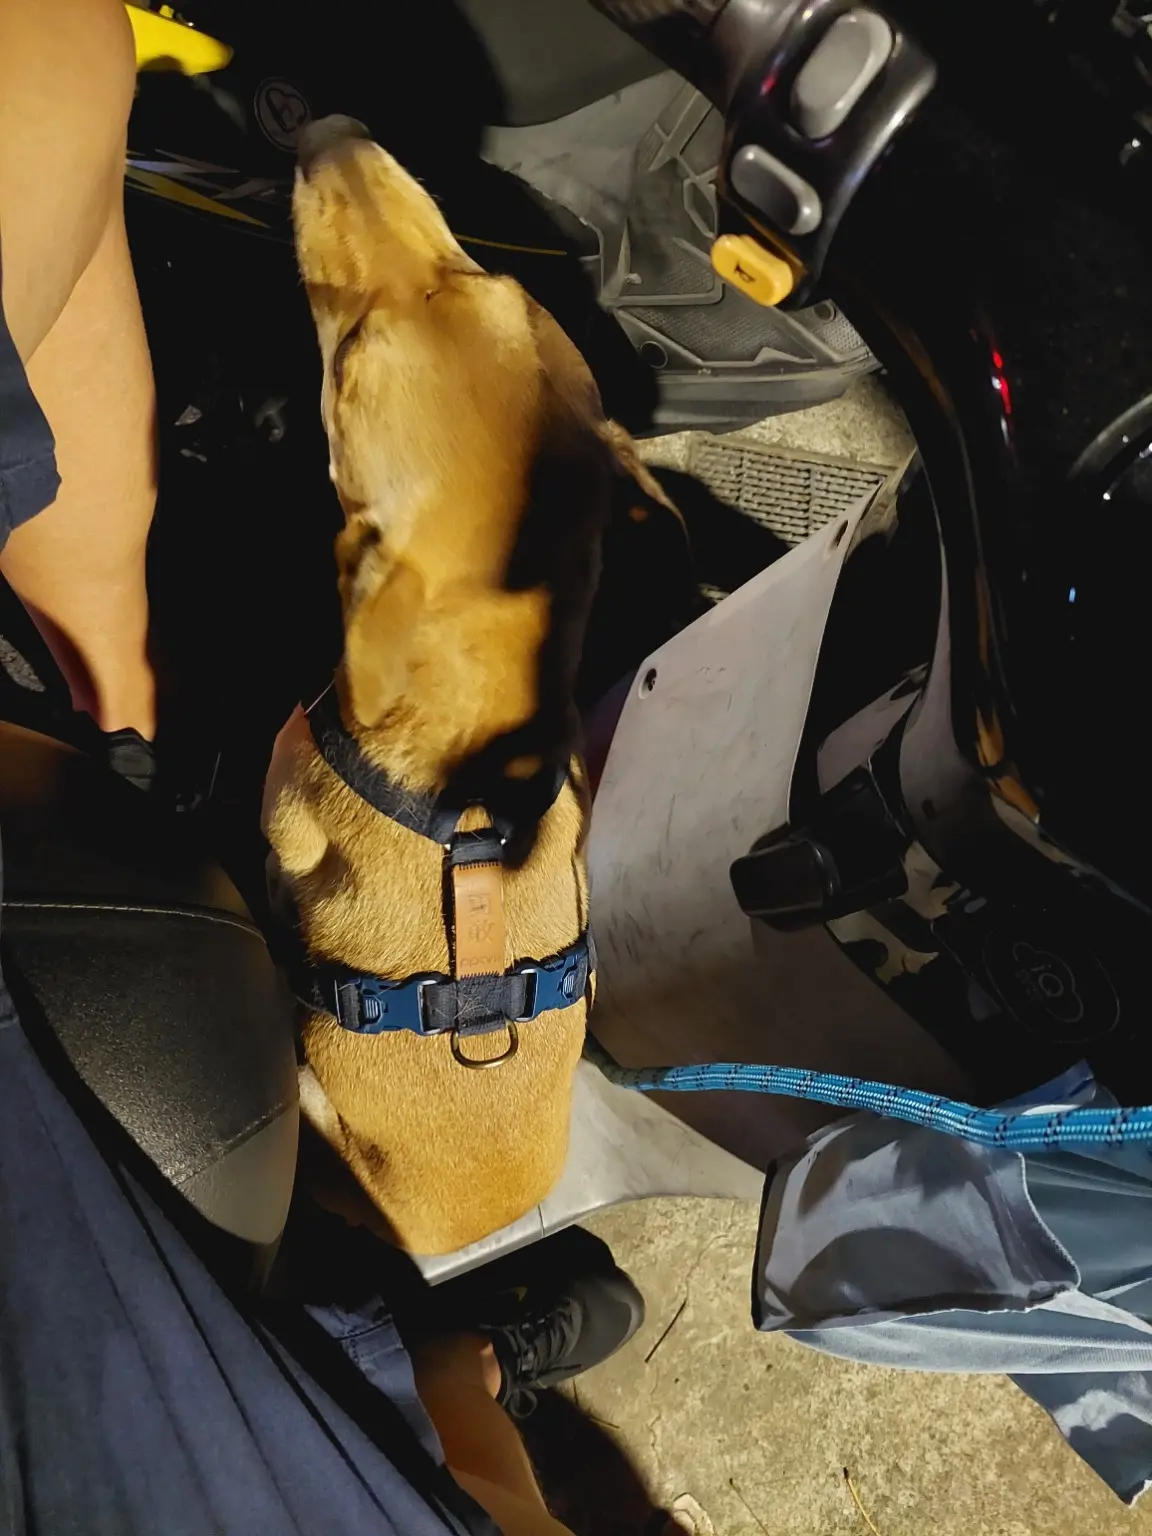
完整影片可見牠在狹窄位置上持續張口喘氣並掃視周邊。最後是在我協助壓臀後坐下,牠仍往外緣移;這些協助與移動也一起記錄。往外移可能與平衡、位置舒適度或想增加距離有關,幾種可能性可從後續連續動作比較。
機車上的觸摸:可能提供支持,但影片不能量心跳
Section titled “機車上的觸摸:可能提供支持,但影片不能量心跳”我在機車上摸牠的頭與耳朵附近;現場體感是摸的時候心跳稍慢,停止摸時又會加快,但沒有回到剛開始那麼快。這是我直接接觸身體時的感覺,心率要透過量測確認。
兩段完整影片中,志強在觸摸期間有部分頭部較穩、眼睛短暫半閉或閉起的畫面,也沒有持續快速躲手;但張口喘氣仍很明顯。ChatGPT認為,熟悉人的觸摸可能提供短暫的社會性支持;接著看觸摸前後姿勢、呼吸與再次接近機車的反應。
後續不需要因為擔心「依賴安撫」便完全不摸。若牠持續接受觸摸,可以逐步增加停止摸的短間隔,觀察喘氣、身體張力和位置能否維持,讓支持慢慢淡出;若出現閃躲、轉頭避開、耳朵更後貼或身體更僵,則不把觸摸硬加上去。
兩個站點各十分鐘:沒有坐下,不等於社會化失敗
Section titled “兩個站點各十分鐘:沒有坐下,不等於社會化失敗”機車之後,我先在經國轉運站附近停留約十分鐘,再到原本的公車站停留約十分鐘。兩個站點志強都沒有坐下。
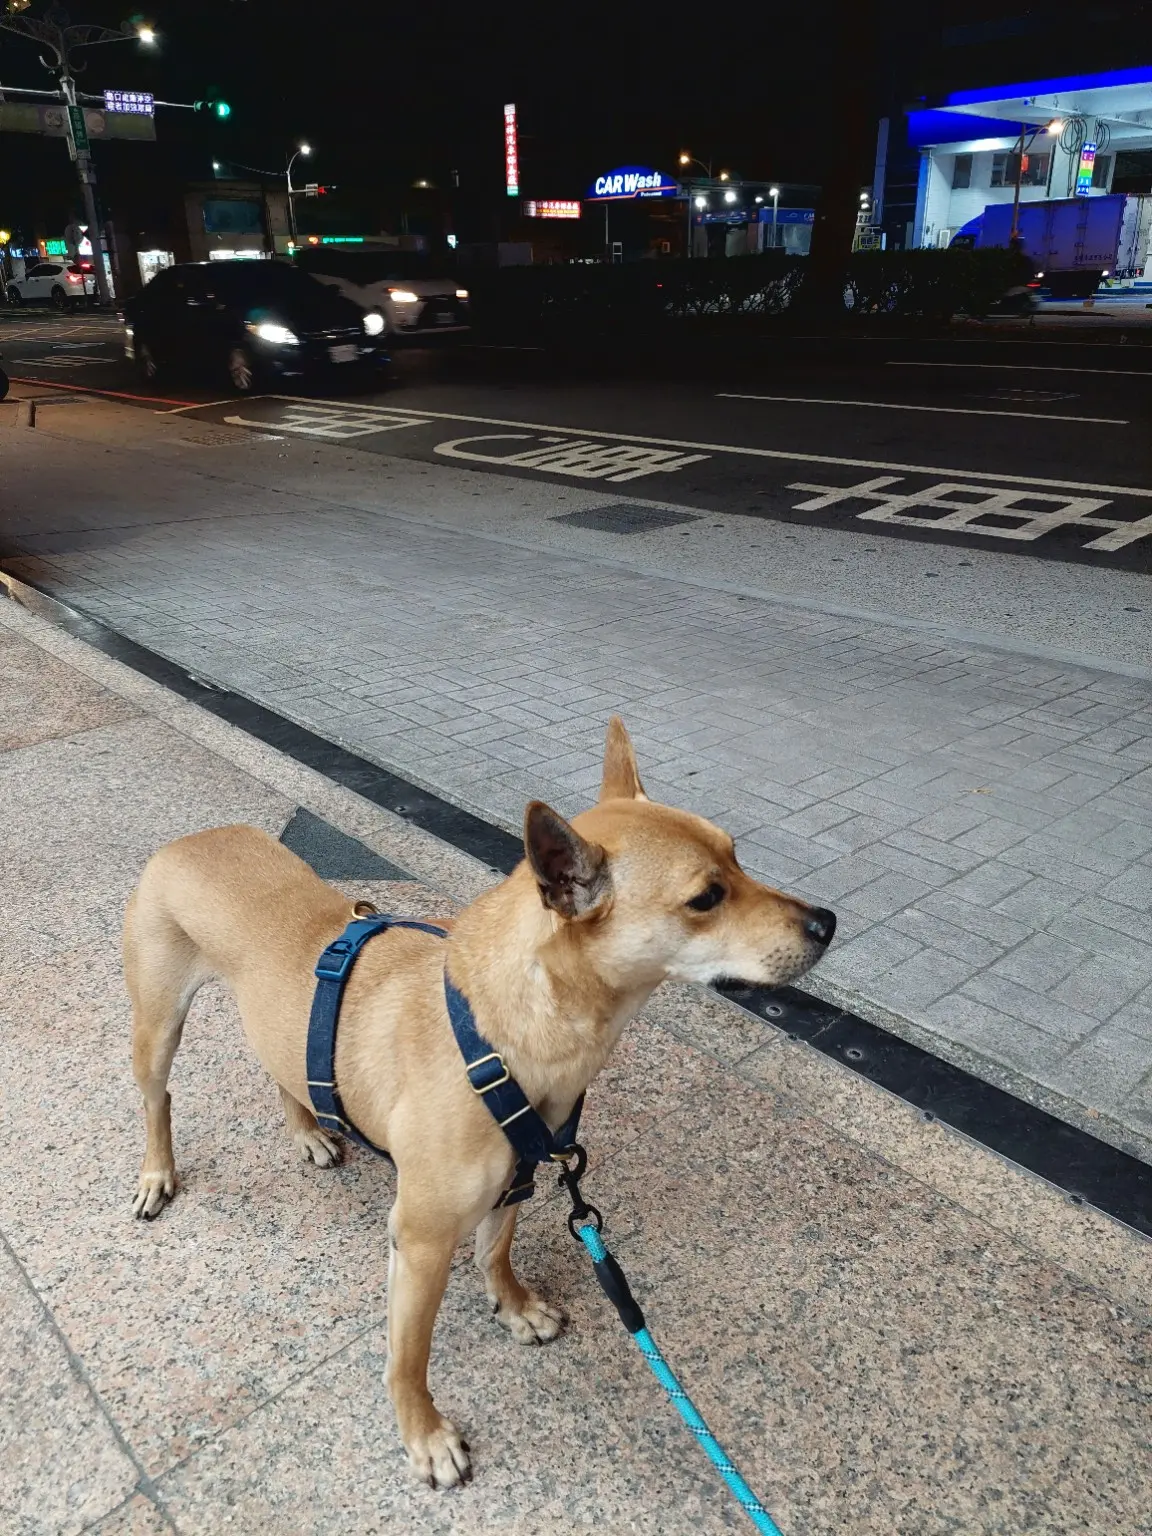
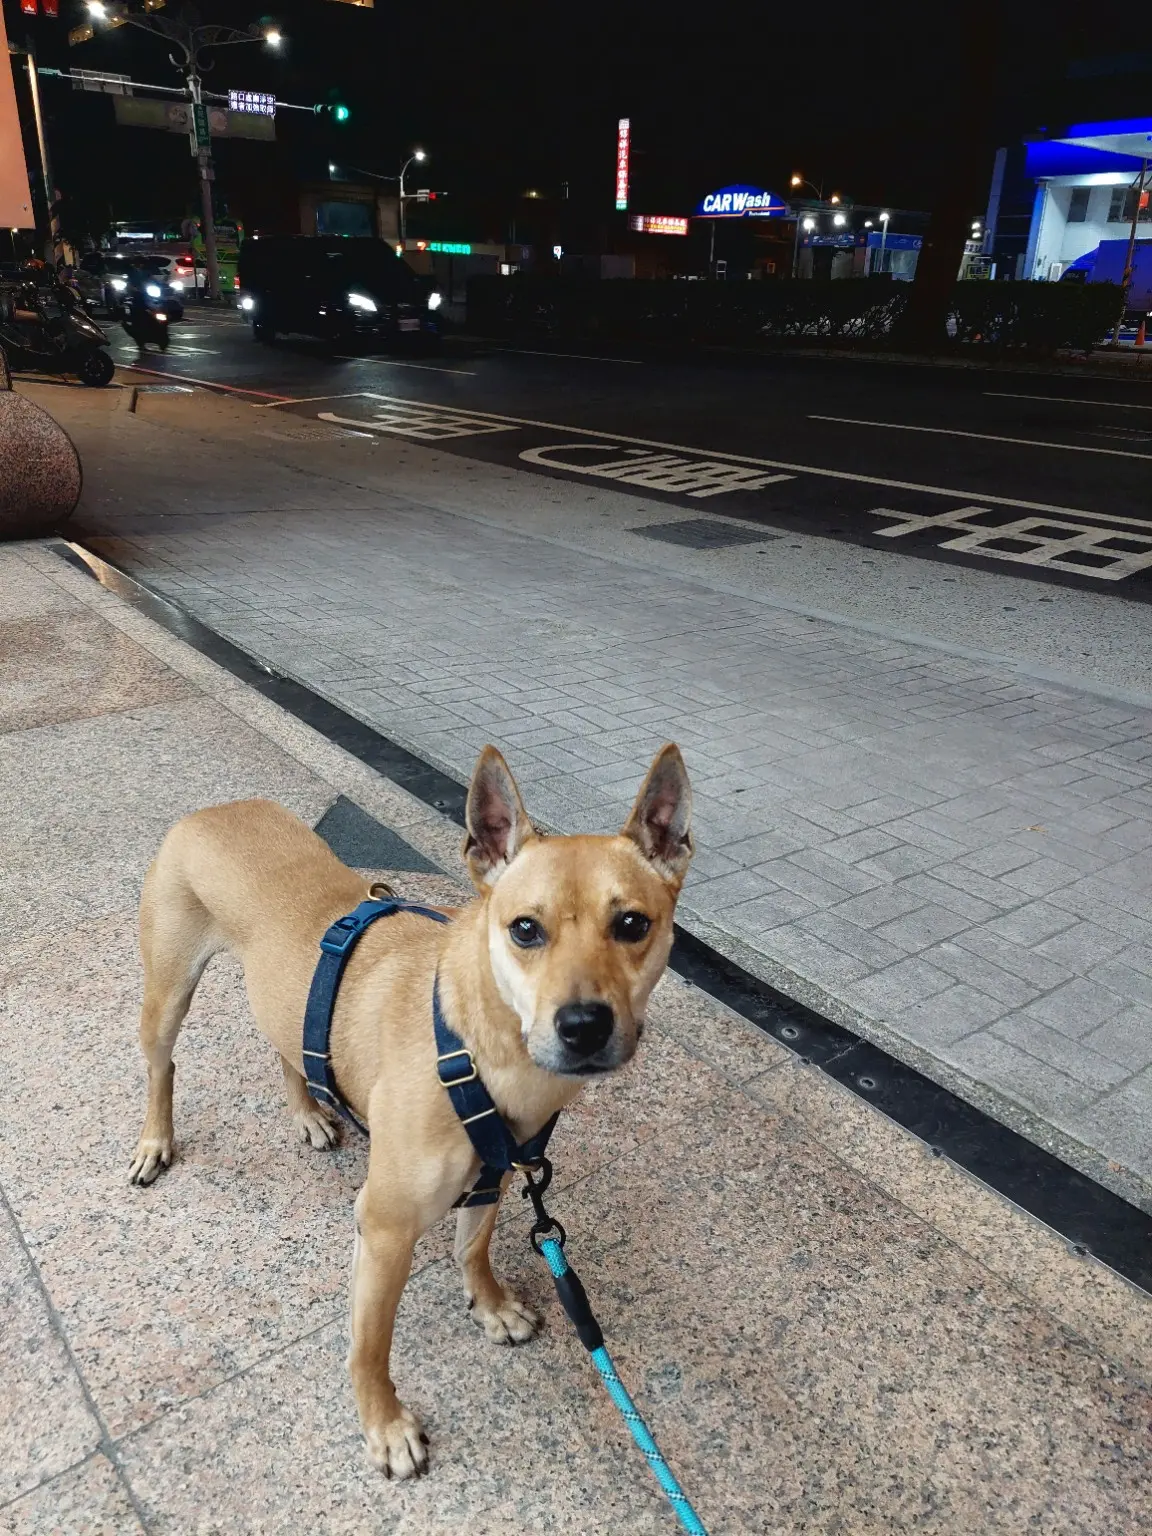
照片中牠保持站立、耳朵持續接收不同方向的刺激,但沒有出現明顯趴伏或縮低到地面的姿勢。今天前面已經完成 B1 與機車,因此我不把「未坐下」寫成失敗。較有意義的指標是能否站著觀察、把視線從刺激移開、開始嗅聞、呼吸下降、回頭查看人,以及最後能否自主移動。兩站連做也增加了整晚工作長度,之後可比較同晚只留一站時的恢復。
返家嘴套與晚餐:第三次退出後停止,110 g 剩 50 g
Section titled “返家嘴套與晚餐:第三次退出後停止,110 g 剩 50 g”回家後,我先從晚餐狗糧中拿一部分做約三、四次嘴套練習。正式晚餐原本提供 110 g,放在濕區並開水聲。志強第一次退出後,我叫牠回去,牠有回去繼續吃;第二次退出後再叫,牠也有回去。第三次退出時,牠已明顯不想再吃,我便讓牠離開,並在牠看得到的情況下把飯收起來。
最後剩 50 g;以 110 g 減去剩量換算,這一餐約吃 60 g。這個 60 g 是算術換算,不是另一次獨立秤重。加上早餐 80 g 與下午分出的 30 g,當天已知狗糧攝取約 170 g;豆漿沒有計入狗糧重量。2026/10/03 補登:10/02 全天總飲水量為 700 mL(700 cc)。
今天第三次退出後停止,沒有再要求一定回去吃完。這和 10/1 最後把剩餘狗糧移到乾區並持續要求吃完不同,也提供了新的對照:退出可以作為當餐難度或食慾的訊號,不必固定演變成「沒吃完就不能離開」。
晚餐原因修正:刺激堆疊只列為候選,不寫成確定因果
Section titled “晚餐原因修正:刺激堆疊只列為候選,不寫成確定因果”較早的討論曾把晚餐沒吃完強烈連到整晚刺激堆疊;但我後來補充,回家後約二十至三十分鐘,志強的心跳、呼吸與一般行為已大致正常。這個後續觀察降低了「前面訓練直接造成晚餐中止」的確定度。
因此正式紀錄只保留幾個並列候選:
- B1、機車與兩站停留留下較輕的刺激殘留;
- 濕區加水聲本身仍有難度;
- 下午 30 g 訓練配額、少量豆漿及晚餐前嘴套,使當天進食節奏不同;
- 身體疲勞;
- 一般食慾波動。
目前沒有資料能把其中一項確定為主因。較好的做法是把「是否恢復正常」和「晚餐是否完成」分開追蹤,也比較不同戶外負荷、是否開水、嘴套是否放在餐前及晚餐後高價值食物安排,而不是用單日晚餐倒推單一原因。
時間距離與固定雞胸肉:精確因果和日程預期不同
Section titled “時間距離與固定雞胸肉:精確因果和日程預期不同”今天也延伸討論狗在隔多久之後仍會形成學習。沒有一個固定分鐘數可以把學習一刀切斷。若結果緊接在行為之後、因果清楚,少數回合便可能建立精確的「做這件事會得到什麼」;時間拉長、中間插入很多事件後,狗較難把最後結果精確歸到很早之前的單一行為。
但另一種是日程或流程預期:如果同一串事件長期、固定、重複,即使前後隔了一段時間,仍可能學到「走到這裡接下來通常會發生什麼」。志強靠近機車前就想離開,較像對固定流程的提前預測;晚餐後固定有雞胸肉遊戲,也可能逐漸成為晚間日程的一部分。
晚餐剩食的原因再連同總食物量、當時環境與後續期待一起看。正常吃完晚餐時,少量雞胸肉遊戲不必取消;偶爾剩飯也不需要立刻全面停掉。但不要在拒吃後立即以大量雞胸肉補成固定替代餐。若晚餐剩量反覆、逐步增加,再減量或暫停晚餐後高價值食物,才比較能測試相對價值與日程預期是否正在影響主食。
習慣化與敏化:同樣是重複,控制權與強度不同
Section titled “習慣化與敏化:同樣是重複,控制權與強度不同”濕區吃飯、站點社會化、B1、汽車與機車,都可能因多次安全、可恢復的經驗而降低反應;差別不是某一項一定能習慣、某一項一定不能,而是控制權、物理限制、刺激強度與身體負荷不同。
濕區吃飯時,志強目前多半能自己走進去、吃、再自行離開,控制權較高。站點停留也能靠距離與離開時機調整。B1 同時包含環境壓力與樓梯動作負荷。汽車通常有較大、穩定與包覆的平面;機車則高、窄、邊緣明顯,還要求平衡,現在又包含被抱上去、被協助坐下與位置被移回內側,控制權最低。
所以重複本身不是充分條件。多次安全且能恢復的體驗可能形成習慣化;多次過強、低控制權且無法恢復的體驗,也可能形成敏化。今天按參與過程、所需協助與恢復情形分別看進展。
後續基準:看逃避起點、恢復與人工介入,而非只看完成
Section titled “後續基準:看逃避起點、恢復與人工介入,而非只看完成”下一次比較機車時,我會看四件事:逃避是從多遠開始、上車後喘氣多久下降、需要多少抱持/壓臀/移位、停止觸摸後能否仍維持。若逃避起點逐漸靠近機車、恢復變快、能自主站穩或坐下、不再往外緣移,而且人工介入與持續觸摸需求下降,才比較支持刺激真的在變小。
反過來,若牠在更遠處便逃、看到那條路就不走、上車後恢復更慢,或需要更多限制才能維持,即使每次最後都完成,也要把敏化列為可能。B1 則追蹤自然可控速度、腳抖是否再現、走完呼吸恢復與停車場逃離傾向;社會化追蹤呼吸、嗅聞、視線轉移及自主坐趴,而不是只記「待滿幾分鐘」。
今天的媒體限制也一併保留:三段完整影片只涵蓋機車上的過程,沒有 B1 樓梯與晚餐影片;照片保留當下姿勢,身體狀態與動機搭配現場觀察和後續動作理解。老師的「可以繼續」是外部專業意見;負荷拆分、支持淡出與多候選解釋則是 ChatGPT 分析,我尚未把它們全部確認為固定操作規則。
10/03 延伸討論|為什麼較多訓練壓力的人,仍可能是主要互動對象
Section titled “10/03 延伸討論|為什麼較多訓練壓力的人,仍可能是主要互動對象”這一段是 10/03 對 10/02 晚間訓練討論的延伸,不是新的 10/03 生活事件。我的疑問是:平常在家工作、和志強相處時間最多的人是我,但 B1、機車、社會化等較多刺激與訓練壓力也主要由我帶;太太的互動則較偏散步、陪伴與少量簡單訓練。照人類家庭的直覺,如果一方常給壓力、另一方比較能安慰,應該會更想找後者;但志強目前反而比較常來找我。
ChatGPT先修正原先過度簡化的說法:狗確實會形成對人的正負社會偏好,也會主動接近某些人、避免某些人。比較不適合的是把整段關係壓成一個單一總分,例如「這個人給我很多壓力,所以我整體不喜歡他」。
比較符合目前行為的理解,是同一個人可以同時帶有多種功能與預測:我是最常出現的人、很多日常事件的資訊來源、食物與出門等資源來源、訓練帶領者,也可能是在陌生刺激中會被志強拿來確認狀況的參照對象。某些情境裡,牠可以不喜歡「我帶牠靠近機車」;但在沒有機車、沒有要求的日常裡,仍主動來找我。這兩種聯想可以同時存在。
因此真正要區分的是「情境性負面聯想」有沒有泛化成「對人的全面迴避」。如果只是看到機車、胸背帶或特定路線時提早想走,而平常仍會主動靠近、討摸、跟隨、休息在附近,較支持壓力目前仍主要綁在特定情境;如果之後變成我一起身就躲、我伸手就退、沒有任何訓練工具時也不願靠近,才比較像負面聯想開始泛化到我這個人本身。
我用「父母一方較嚴厲、一方較安慰」做類比時,ChatGPT 認為這個比喻有一部分成立,但狗的「找誰」還混合了可預測性、熟悉度、資源、資訊與依附等因素。對狗而言,一個人很常帶牠做困難的事,日常照護與愉快互動仍會影響牠對這個人的偏好;只要整體互動仍可預測、會結束、會恢復,而且日常仍有大量中性與正向共處,牠可能把「這個情境很難」和「這個人很重要」分開學。
10/03 延伸討論|頂手討摸不只是「看我在做什麼」,也包含主動社交價值
Section titled “10/03 延伸討論|頂手討摸不只是「看我在做什麼」,也包含主動社交價值”我再補了一個更具體的家庭情境:有時我和太太都在家,太太一開始正在摸志強;只要我起身或稍微移動,志強就會跑來找我,而且不是只看一下,而是會頂我的手,明確要求我摸牠。我如果故意不摸、叫太太繼續摸,牠通常還能接受;但只要我又有動作,牠可能再次跑來要求我摸。
這個補充讓判讀比單純「我是高資訊量的人」更進一步。如果志強只是因我的移動而更新資訊,理論上確認我在做什麼後便可以離開;但「跑過來 → 靠近 → 頂手 → 等我摸 → 停摸後再次要求」表示和我發生身體社交互動本身很可能具有正向價值。
目前較適合把這件事拆成三層,而且三層可以同時成立:
- 可預測性/社會參照:我一動,因為平常很多事情由我開始,所以志強容易先注意我。
- 學習史:牠已經學會「頂我的手」通常能讓摸摸開始,因此這個要求行為本身會被過去成功經驗維持。
- 社會偏好:在我和太太都能提供接觸時,牠仍反覆轉回來要求我的觸摸,表示至少在「主動討摸、尋求注意與互動」這一類情境中,我目前的社交價值較高。
整段關係需要按不同情境的主動接近與互動經驗長期比較。志強可能更常找我討摸與確認,又可能在其他情境更喜歡跟太太散步、休息或接受某些照護。較精確的說法是:我目前不只是志強需要追蹤的高資訊量人物,我的注意力與觸摸本身也已成為牠會主動爭取的社交資源。
如果要把「只是追蹤我的動作」和「自由選擇我做社交互動」拆得更乾淨,可以做家庭自由選擇觀察:我和太太都坐著、都不叫牠、不拿食物、不主動摸,隔開一段距離,觀察十至十五分鐘牠主動靠近誰、停留多久、向誰頂手、誰停摸後牠會再次要求;不同日子交換兩人的座位,減少單純位置偏好的干擾。
10/03 延伸討論|讓志強更常主動找太太:增加她自己的低壓社交價值
Section titled “10/03 延伸討論|讓志強更常主動找太太:增加她自己的低壓社交價值”我的下一個目標不是讓志強少找我,而是希望牠也能更常主動找太太。ChatGPT 建議不要用「把我抽掉、逼牠改找太太」的方式處理,而是另外建立一條清楚的學習歷史:主動找太太,也會發生舒服、可預測而且低壓的互動。
現階段較適合先把志強本來就喜歡、成功率高、壓力低的活動多分一些給太太,例如固定一小段散步、簡單嗅聞遊戲、少量雞胸肉遊戲,或已熟悉的坐下/趴下。現在不需要刻意把最困難的 B1、機車等高刺激工作交給太太,因為目標是先增加她自己的正向社交價值,不是重新分配壓力來源。
另外可安排短而固定的太太專屬互動:太太坐著,不主動把志強叫過來;志強自己靠近後再摸五至十秒,停手觀察。若牠留下、再頂手或重新要求,太太才繼續。這樣比較像在建立「我主動靠近太太 → 互動會發生」,而不是「太太一直追著我摸」。
如果太太正在和志強互動,而我只是因起身或小幅移動就讓牠跑過來,我可以先維持中性,不立刻摸、不把牠叫走,也不做責備,給牠機會自己重新選擇是否回到太太附近。這不是拒絕牠,而是避免每一次「離開太太找我」都固定得到更強、更快的社交回饋。
可以先用兩週做小型觀察:每天由太太安排兩次、每次約五分鐘的低壓專屬互動,我可以在場但不介入。主要看四個指標:志強主動靠近太太的次數、是否更常頂太太的手、我不介入時牠是否會自己回到太太附近,以及兩人同時中性時自由停留時間是否逐漸改變。成功條件不是「牠必須少找我」,而是太太逐漸成為另一個牠會主動選擇的社交對象。
這一輪也延續 10/02 的核心原則:訓練壓力、情境預測、主要照顧者角色與社會偏好可以同時存在,具體找誰、何時靠近及互動後的反應,分別記錄比較。