2026/09/26|早餐餐窗、嘴套成功條件與公車站第 19 分鐘趴下
2026/09/26|早餐餐窗、嘴套成功條件與公車站第 19 分鐘趴下
Section titled “2026/09/26|早餐餐窗、嘴套成功條件與公車站第 19 分鐘趴下”清晨與早餐|提早散步,80 g 最後剩 18 g
Section titled “清晨與早餐|提早散步,80 g 最後剩 18 g”今天早上因為我要外出,約 06:00 多便先帶志強散步,約 07:30~08:00 回家,早餐也跟著提早。今天沒有做近期的浴室早餐;我把 80 g 狗糧帶進隔離房,在旁邊看牠吃。
志強吃到一半幾次停下來看我。前兩次我做出要收碗的動作,牠都立刻轉回去繼續吃;第三次再停下時,我平靜把碗收走並離開。最後剩 18 g,早餐實吃約 62 g。
ChatGPT 認為,短暫停下可能包含互動期待或環境確認;反覆「假裝收碗」則可能形成新的促食互動鏈。臨時趕時間時,較清楚的做法是給一個實際可行的餐窗,到時間便平靜收走,不陪吃、不催,也不因剩食立即補更好的食物。
約 16:00|38 g 訓練:嘴套追蹤卡住,重設後仍願意靠近
Section titled “約 16:00|38 g 訓練:嘴套追蹤卡住,重設後仍願意靠近”我回家後志強自行出房。我把早餐剩下的 18 g 加上 20 g 新狗糧,共 38 g,先做跟隨,再做嘴套與 15 分鐘籠內訓練。
嘴套靜態取食順利。我接著嘗試在牠伸嘴取食時把嘴套往前移;牠最初會趕快跟上,但連續幾次快追到時我又把嘴套拉開,牠便停住、不再往前。重新設定情境後,牠仍會再次主動靠近並伸嘴,因此我把難度降回「移到一個定點後停住,讓牠自己靠近吃」。15 分鐘籠內訓練沒有明顯問題。
這次讓我重新區分兩種「努力」:固定目標上的反覆試錯,和人為把成功條件一直往後移,並不是同一件事。ChatGPT 也修正先前「牠在評估值不值得」的擬人化說法:較精確的是,牠會依近期結果調整行為持續度。野外追逐也不是每次都追到底;活體獵物的移動本身可能維持追逐動機,嘴套目前則主要靠食物建立價值,兩種情境的吸引力來源有差異。這次停下來較適合放回成功條件反覆改變的過程理解。
完整討論整理於成功條件、挫折與嘴套追蹤案例。
下午|第一次試吃清水燙蚵仔
Section titled “下午|第一次試吃清水燙蚵仔”我做蚵仔煎時,另外挑幾顆蚵仔只用清水燙熟、沒有調味,再把其中一顆切小塊給志強試吃。牠先聞了一段時間,接著舔、含進嘴裡,但出現吃進去又掉出來、再試又掉出的情形。後續再次提供時,牠已沒有明顯興趣。
ChatGPT 的工作判讀是:這較像對新食物有好奇,但偏好/適口性普通;濕滑柔軟的陌生口感與切得太小,也可能讓第一次口腔處理比較困難。後續興趣下降使「不太喜歡」比「完全不知道怎麼吃」更合理,口感因素則仍保留為後續可比較的可能性。完整比較見第一次吃蚵仔案例。
晚間散步|直接到公車站,約第 19 分鐘才坐下、趴下
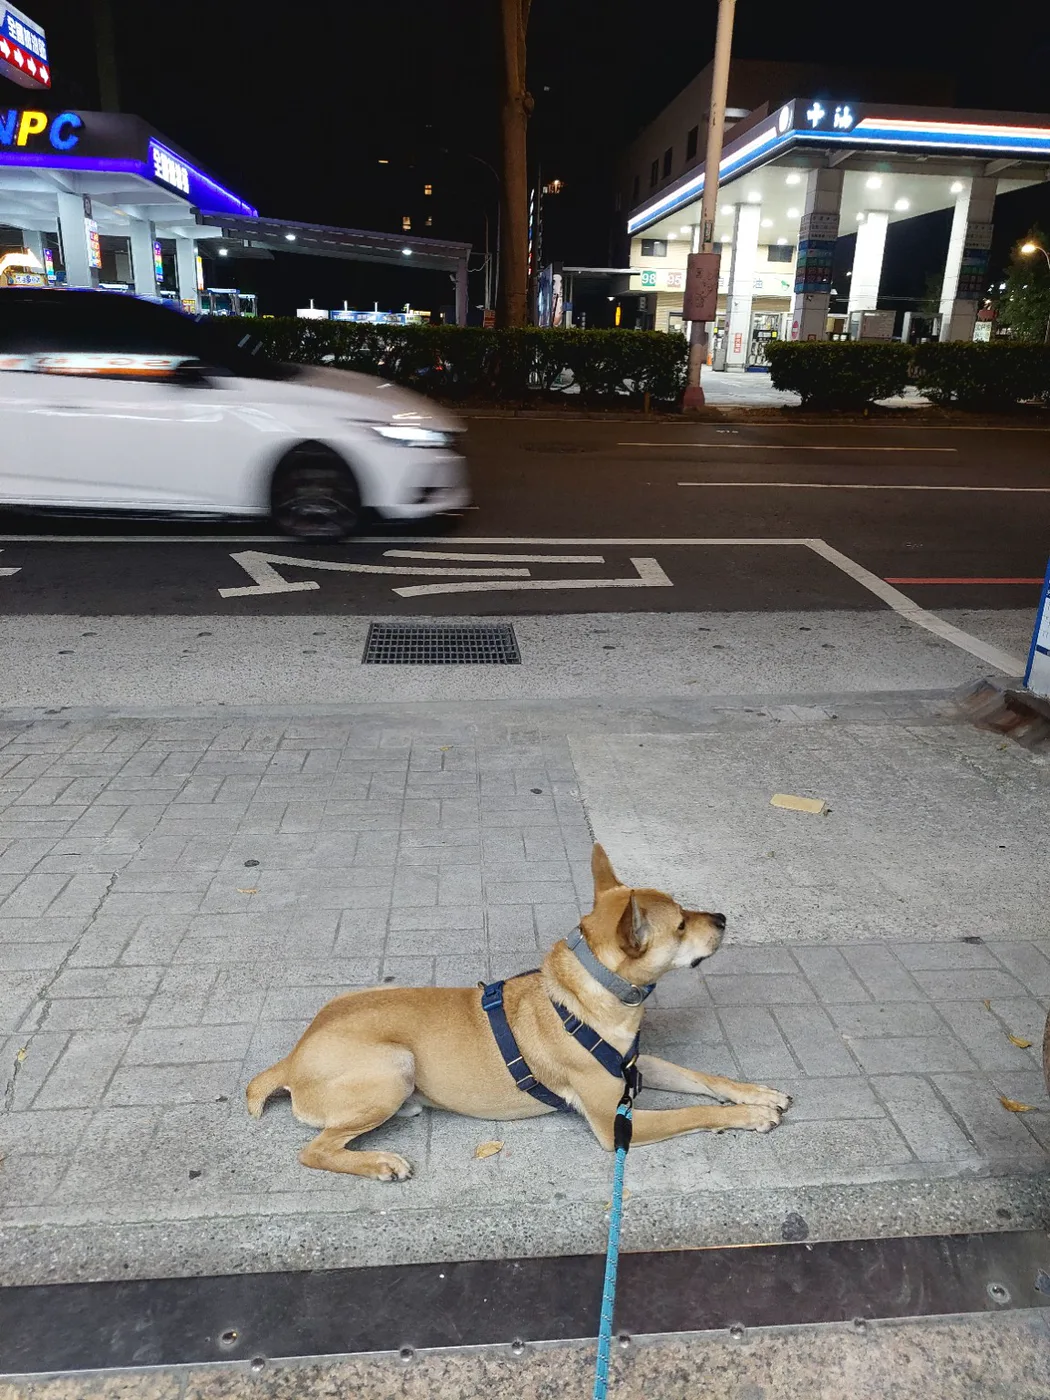
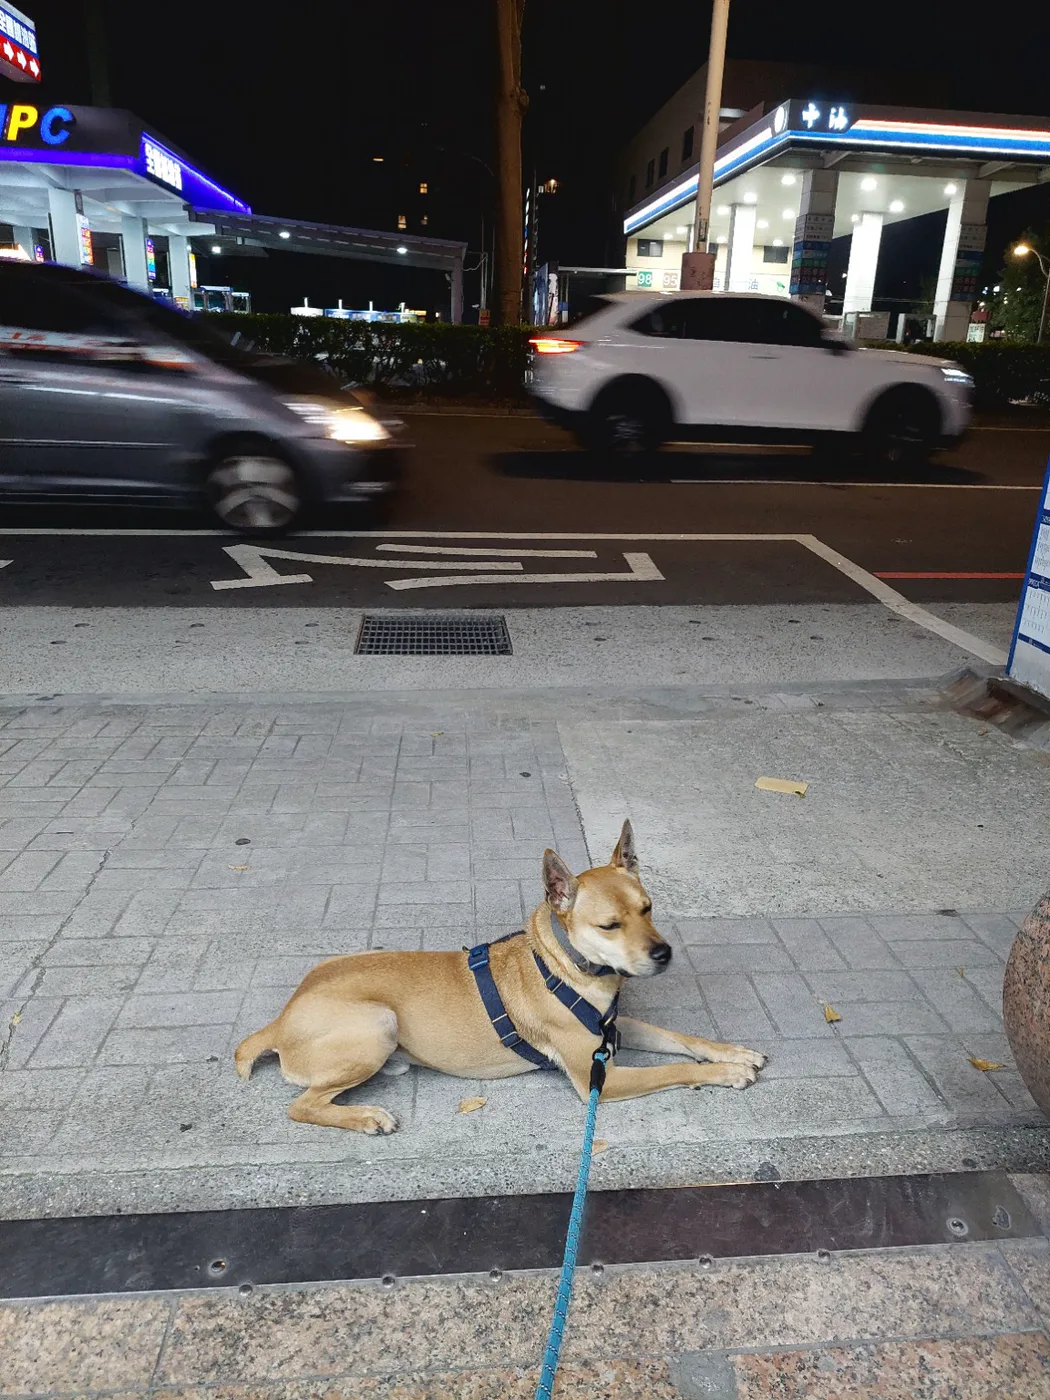
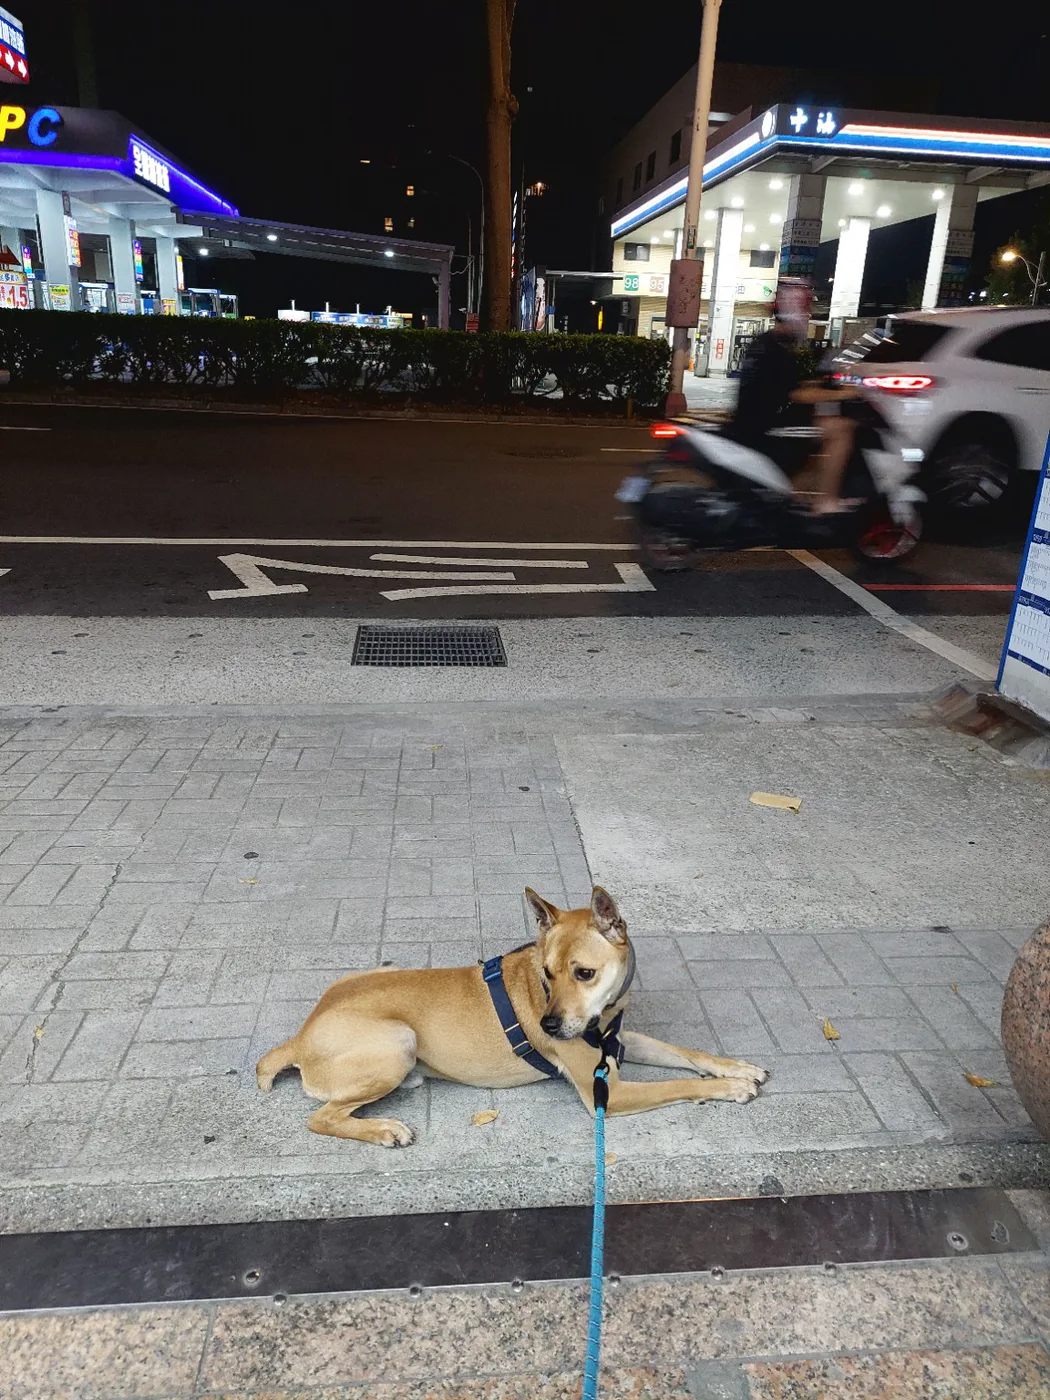
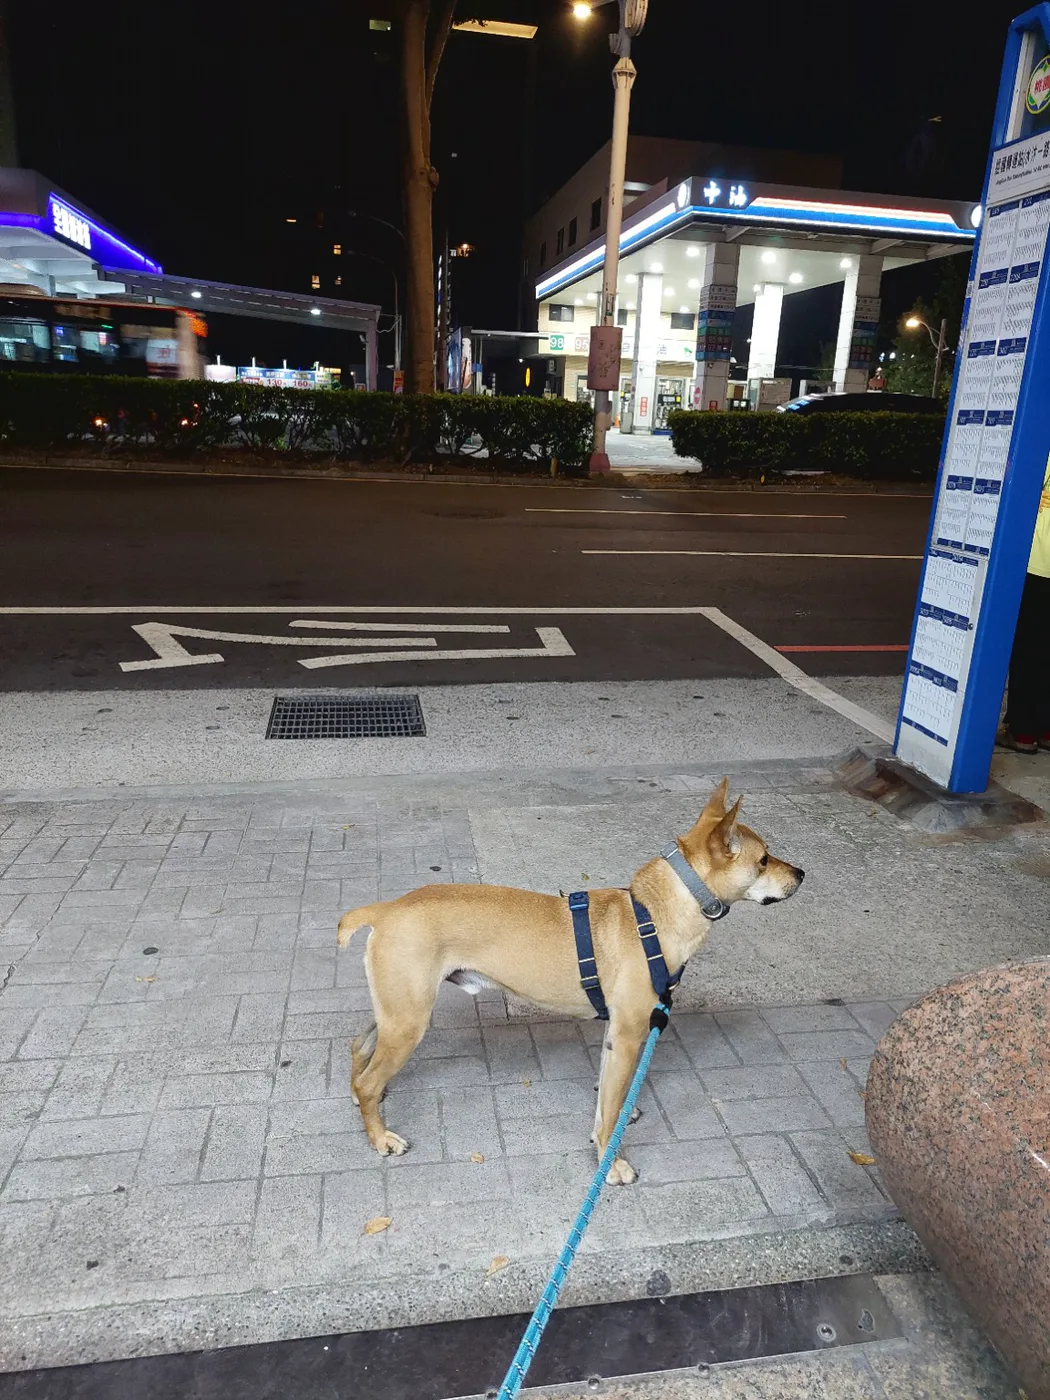
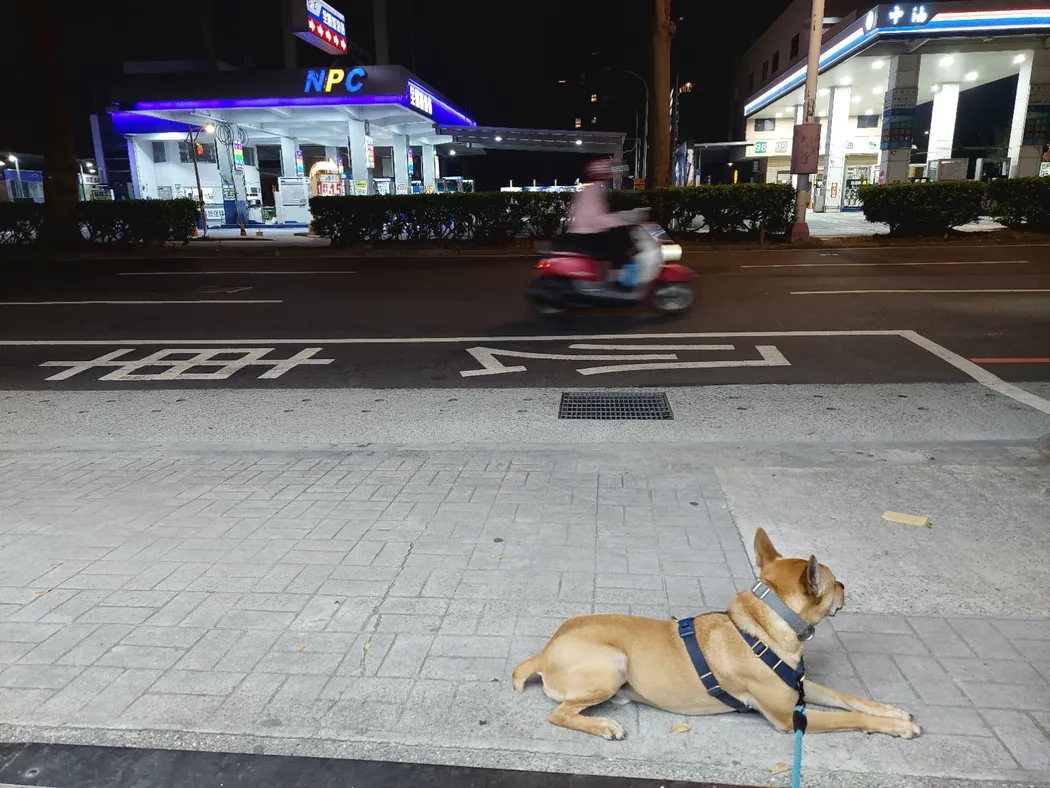
Section titled “晚間散步|直接到公車站,約第 19 分鐘才坐下、趴下”今天沒有先走平常那段路,而是直接往公車站。原本不是刻意要做 20 分鐘,但我們在現場討論事情,停留自然延長。志強前面大多站著,約到 第 19 分鐘才自行坐下、接著趴下;趴下約 1~2 分鐘後,疑似注意到外界刺激又站起來查看。
我主觀覺得今天車流可能比昨天稍多,但沒有計數;另外,直接到站也代表前置散步量較少。比較「9/25 約第 6 分鐘趴下」和「今天第 19 分鐘趴下」時,13 分鐘的差距要連同這兩個變因一起看。
照片顯示牠趴著時仍抬頭、豎耳並追蹤道路刺激,較適合寫成「能趴著持續觀察」,不是深度放鬆。後續除了首次趴下時間,也會記錄因刺激起身後多久能再次自行坐下或趴下。完整拆解見公車站停留的變因案例。
晚餐|前段在門口評估,我進入後才跟進濕區
Section titled “晚餐|前段在門口評估,我進入後才跟進濕區”晚餐延續濕區+水聲練習。完整影片約 232.4 秒。重新逐格檢查後,前段時序修正如下:我約在 00:41~00:44 移入濕區並站定;志強當時沒有立即跟進。約 00:58~01:00 仍停在門檻外觀察,約 01:04~01:05 一度退開,之後再返回入口;約 01:07 開始把前腳跨進濕區,約 01:12 四腳都已進入並往食盆前進。約 01:20 之後進食逐漸穩定;約 03:10 可見短暫抬頭查看但身體仍留在濕區,約 03:45 接近尾段時仍在裡面進食。
這次最清楚的拆分仍是:主要瓶頸在「開始跨過門檻」,不是「進去後能不能待著吃」。逐格重看也修正了原先的時間標記:我先進去後,志強仍在外側停留約 20 多秒,期間甚至短暫退開再返回。因此我的位置很可能降低不確定性或提供安全提示,但不是我一進去牠就機械式跟隨;牠仍有一段自行評估、接近、退開再回來的過程。後續會逐步淡化我的協助,分開記首次探頭/跨腳時間、是否需要我先進、我進入後多久跟進,以及進去後能否留到餐末。
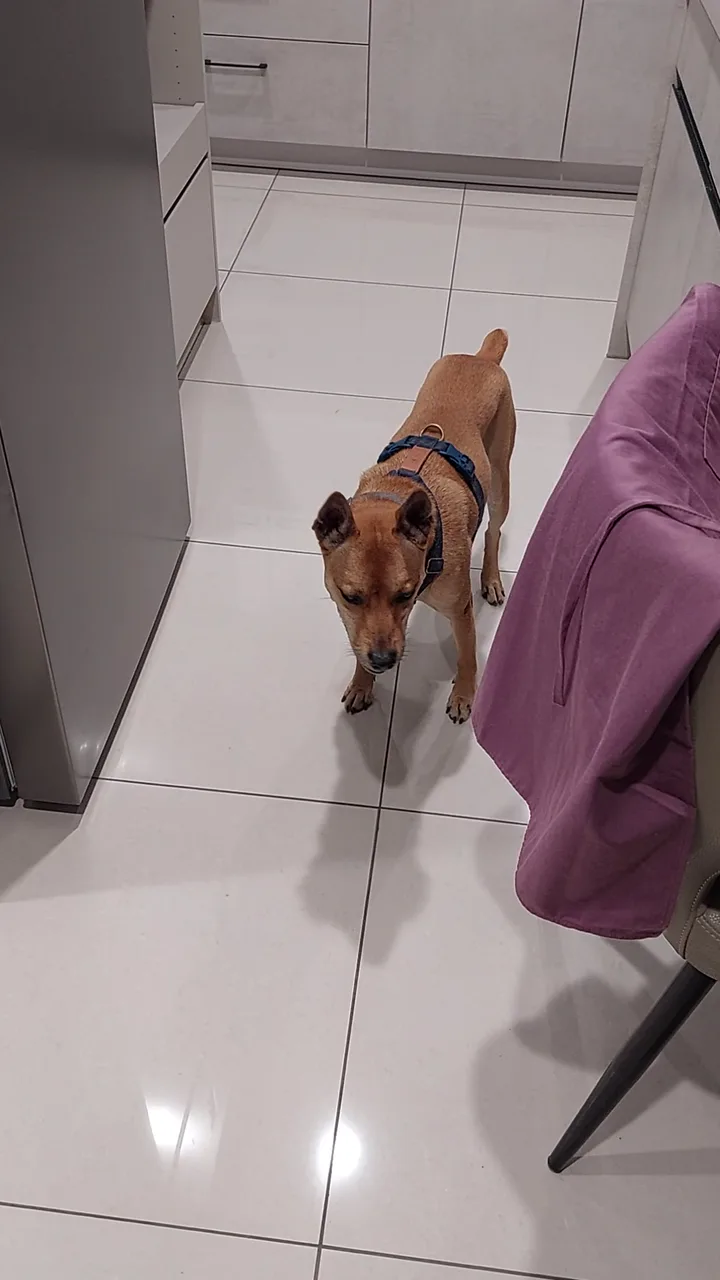
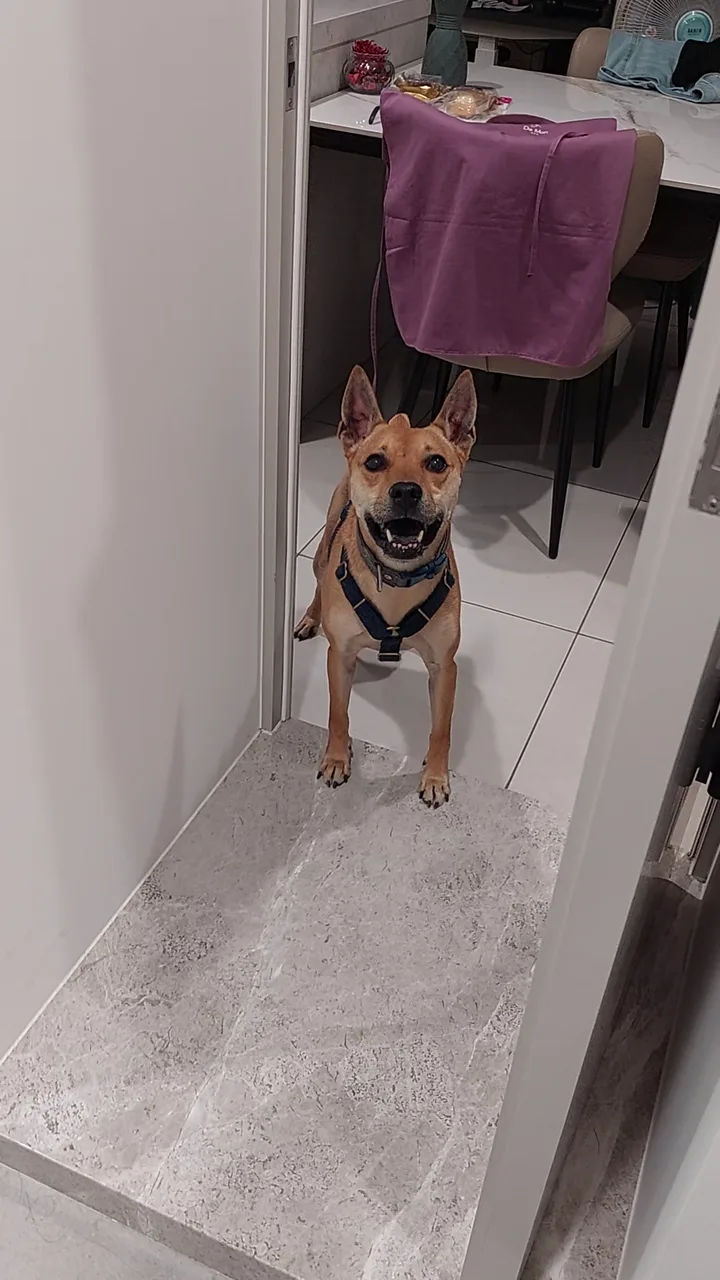
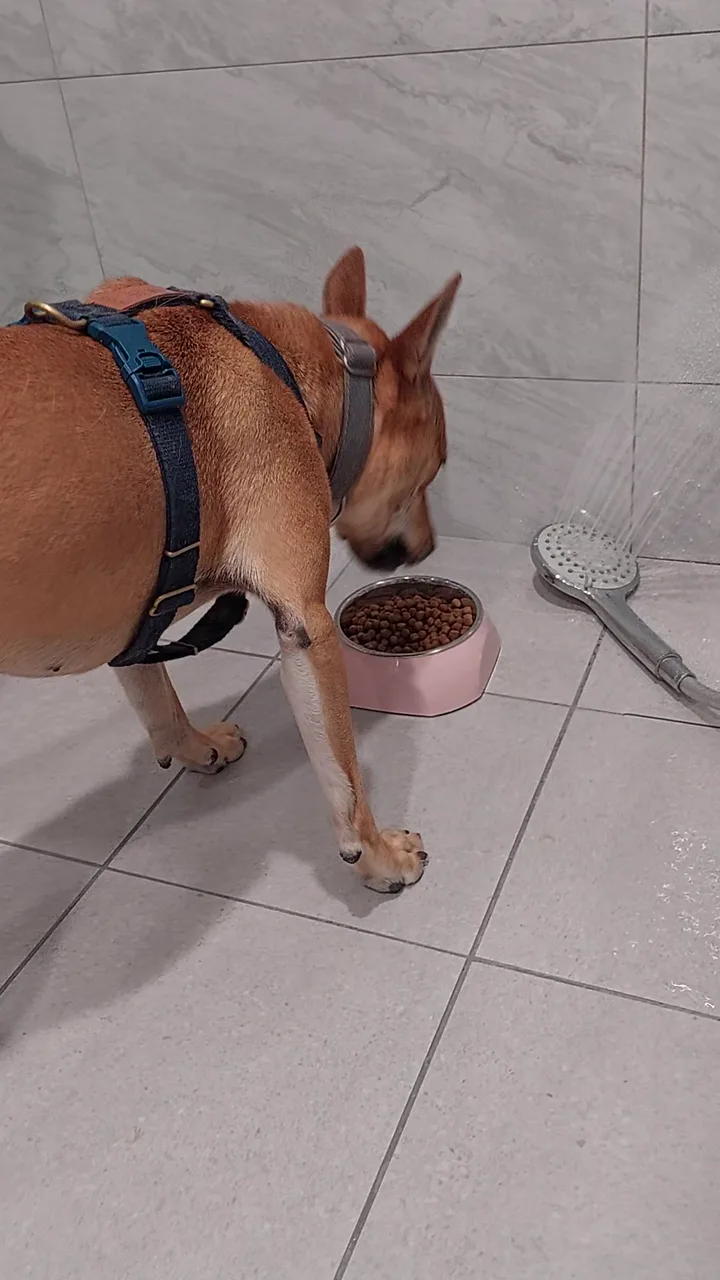
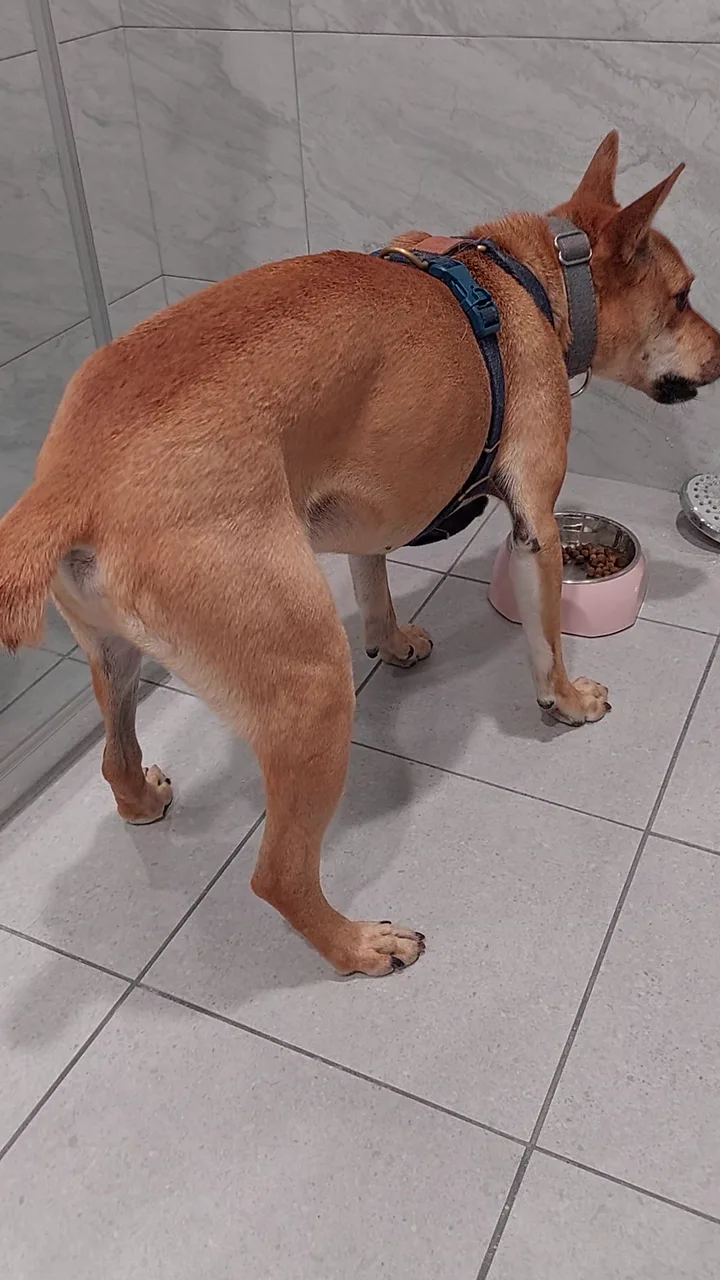
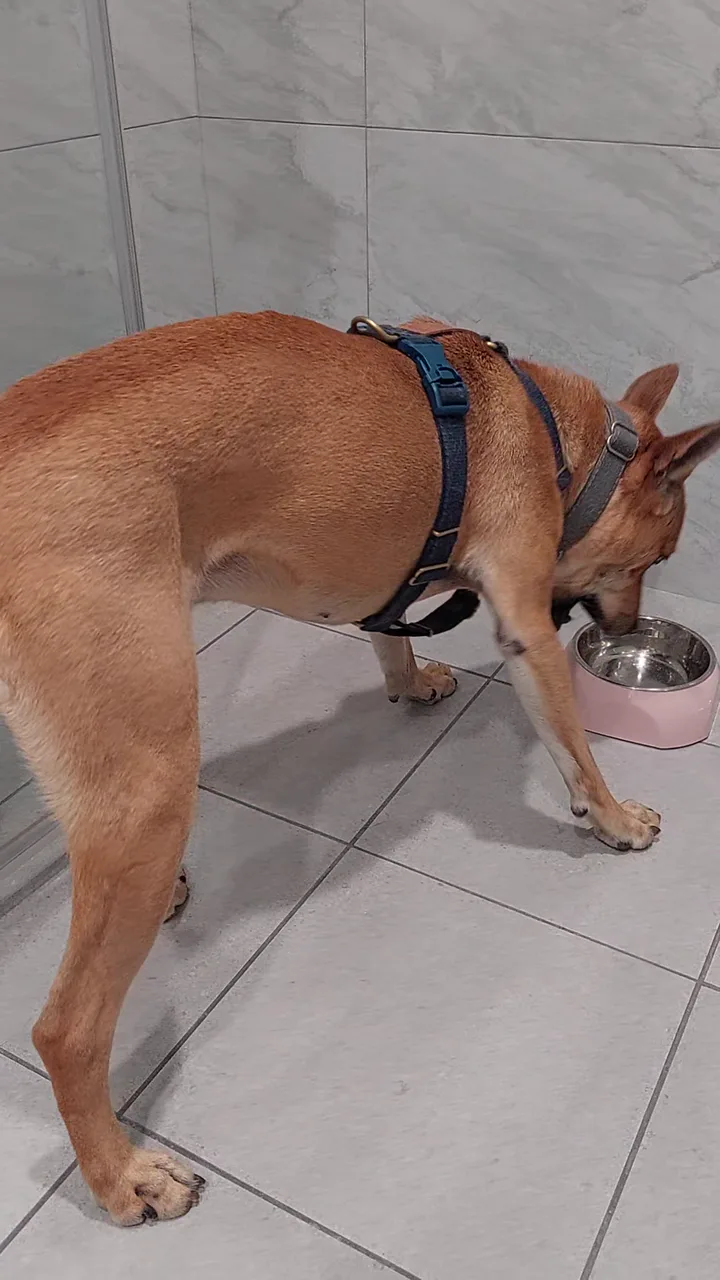
影片保留本次 Drive 檔案的完整 232.4 秒時序與音訊。
晚餐後|雞胸肉嘴套:改成固定目標後順利取食
Section titled “晚餐後|雞胸肉嘴套:改成固定目標後順利取食”晚上我另用雞胸肉做嘴套練習。這次不再讓志強長距離追著持續移動的嘴套,而是帶牠到一個位置後停下;牠會主動把嘴伸進去取食,過程順利。吃完後仍在附近嗅聞地板,沒有立即退開。
這次結果支持先讓規則保持清楚:靠近嘴套、主動伸嘴,便能穩定取得食物。地板嗅聞很可能只是食物搜尋的延續;若不希望牠長時間搜尋,可以短暫允許確認後,用固定結束提示帶離,而不是把所有低頭嗅聞都列為禁止。
接著|雞胸肉拋接結束後,兩次高速回到行軍床
Section titled “接著|雞胸肉拋接結束後,兩次高速回到行軍床”雞胸肉嘴套訓練後,我接著在隔離房行軍床做雞胸肉拋接。開始時我指行軍床約兩三次,志強才站上去;站上後拋接整體順利。
我說「結束了」離開後,牠高速衝出房間、繞到廚房中島附近,再衝回隔離房站上行軍床等待;相同流程連續出現兩次,途中有打滑。第三次牠又想衝回去時,我稍微擋住路線;牠停下來看我、明顯喘,安靜約十幾秒後逐漸降下來。之後出門尿尿時,喚醒看起來仍偏高。
這不像完全沒有方向的跑圈:每次都精準回到同一張行軍床,較像高喚醒下重新執行剛才最有效的遊戲啟動策略。後續若要有第二輪,會先讓第一輪真正結束、降下來,再由我主動重新開始;不讓高速跑回床直接換到遊戲重啟。完整討論見遊戲重啟、高喚醒與開始/結束規則案例。
今天留下的追蹤點
Section titled “今天留下的追蹤點”- 早餐臨時提早時,使用固定餐窗,不再用反覆假收碗促食。
- 嘴套移動先拆成很小距離,達到當回合標準就讓牠真正取得食物。
- 公車站同時記錄前置散步時間、主觀刺激強度、首次坐/趴、起身後再趴所需時間。
- 濕區分開追蹤「自主跨入」與「進入後持續進食」。
- 高價值拋接在全力爆衝前收尾,結束後切換低刺激活動並改善止滑。